Как распознать PDF с помощью OCR (сделать его доступным для поиска)
Пошаговое руководство: как сделать сканы PDF доступными для поиска с помощью OCR, выбрать языки документа, текстовый слой добавляется локально в браузере.
Распознать текстОтсканированный PDF похож на фотографию текста: он выглядит читаемым, но для любого поиска, копирования и извлечения текста страницы пусты. OCR (оптическое распознавание символов) исправляет это: распознаёт буквы и добавляет невидимый текстовый слой поверх скана. В этом руководстве показано, как это сделать с помощью инструмента OCR PDF от AmiPDF, который выполняет всё распознавание в вашем браузере: файл не покидает устройство, что важно для договоров, медицинских карт и удостоверяющих документов. Вы выбираете один или несколько языков документа, инструмент распознаёт каждую страницу, а на выходе получается тот же PDF, теперь доступный для поиска и копирования.
Пошаговое распознавание
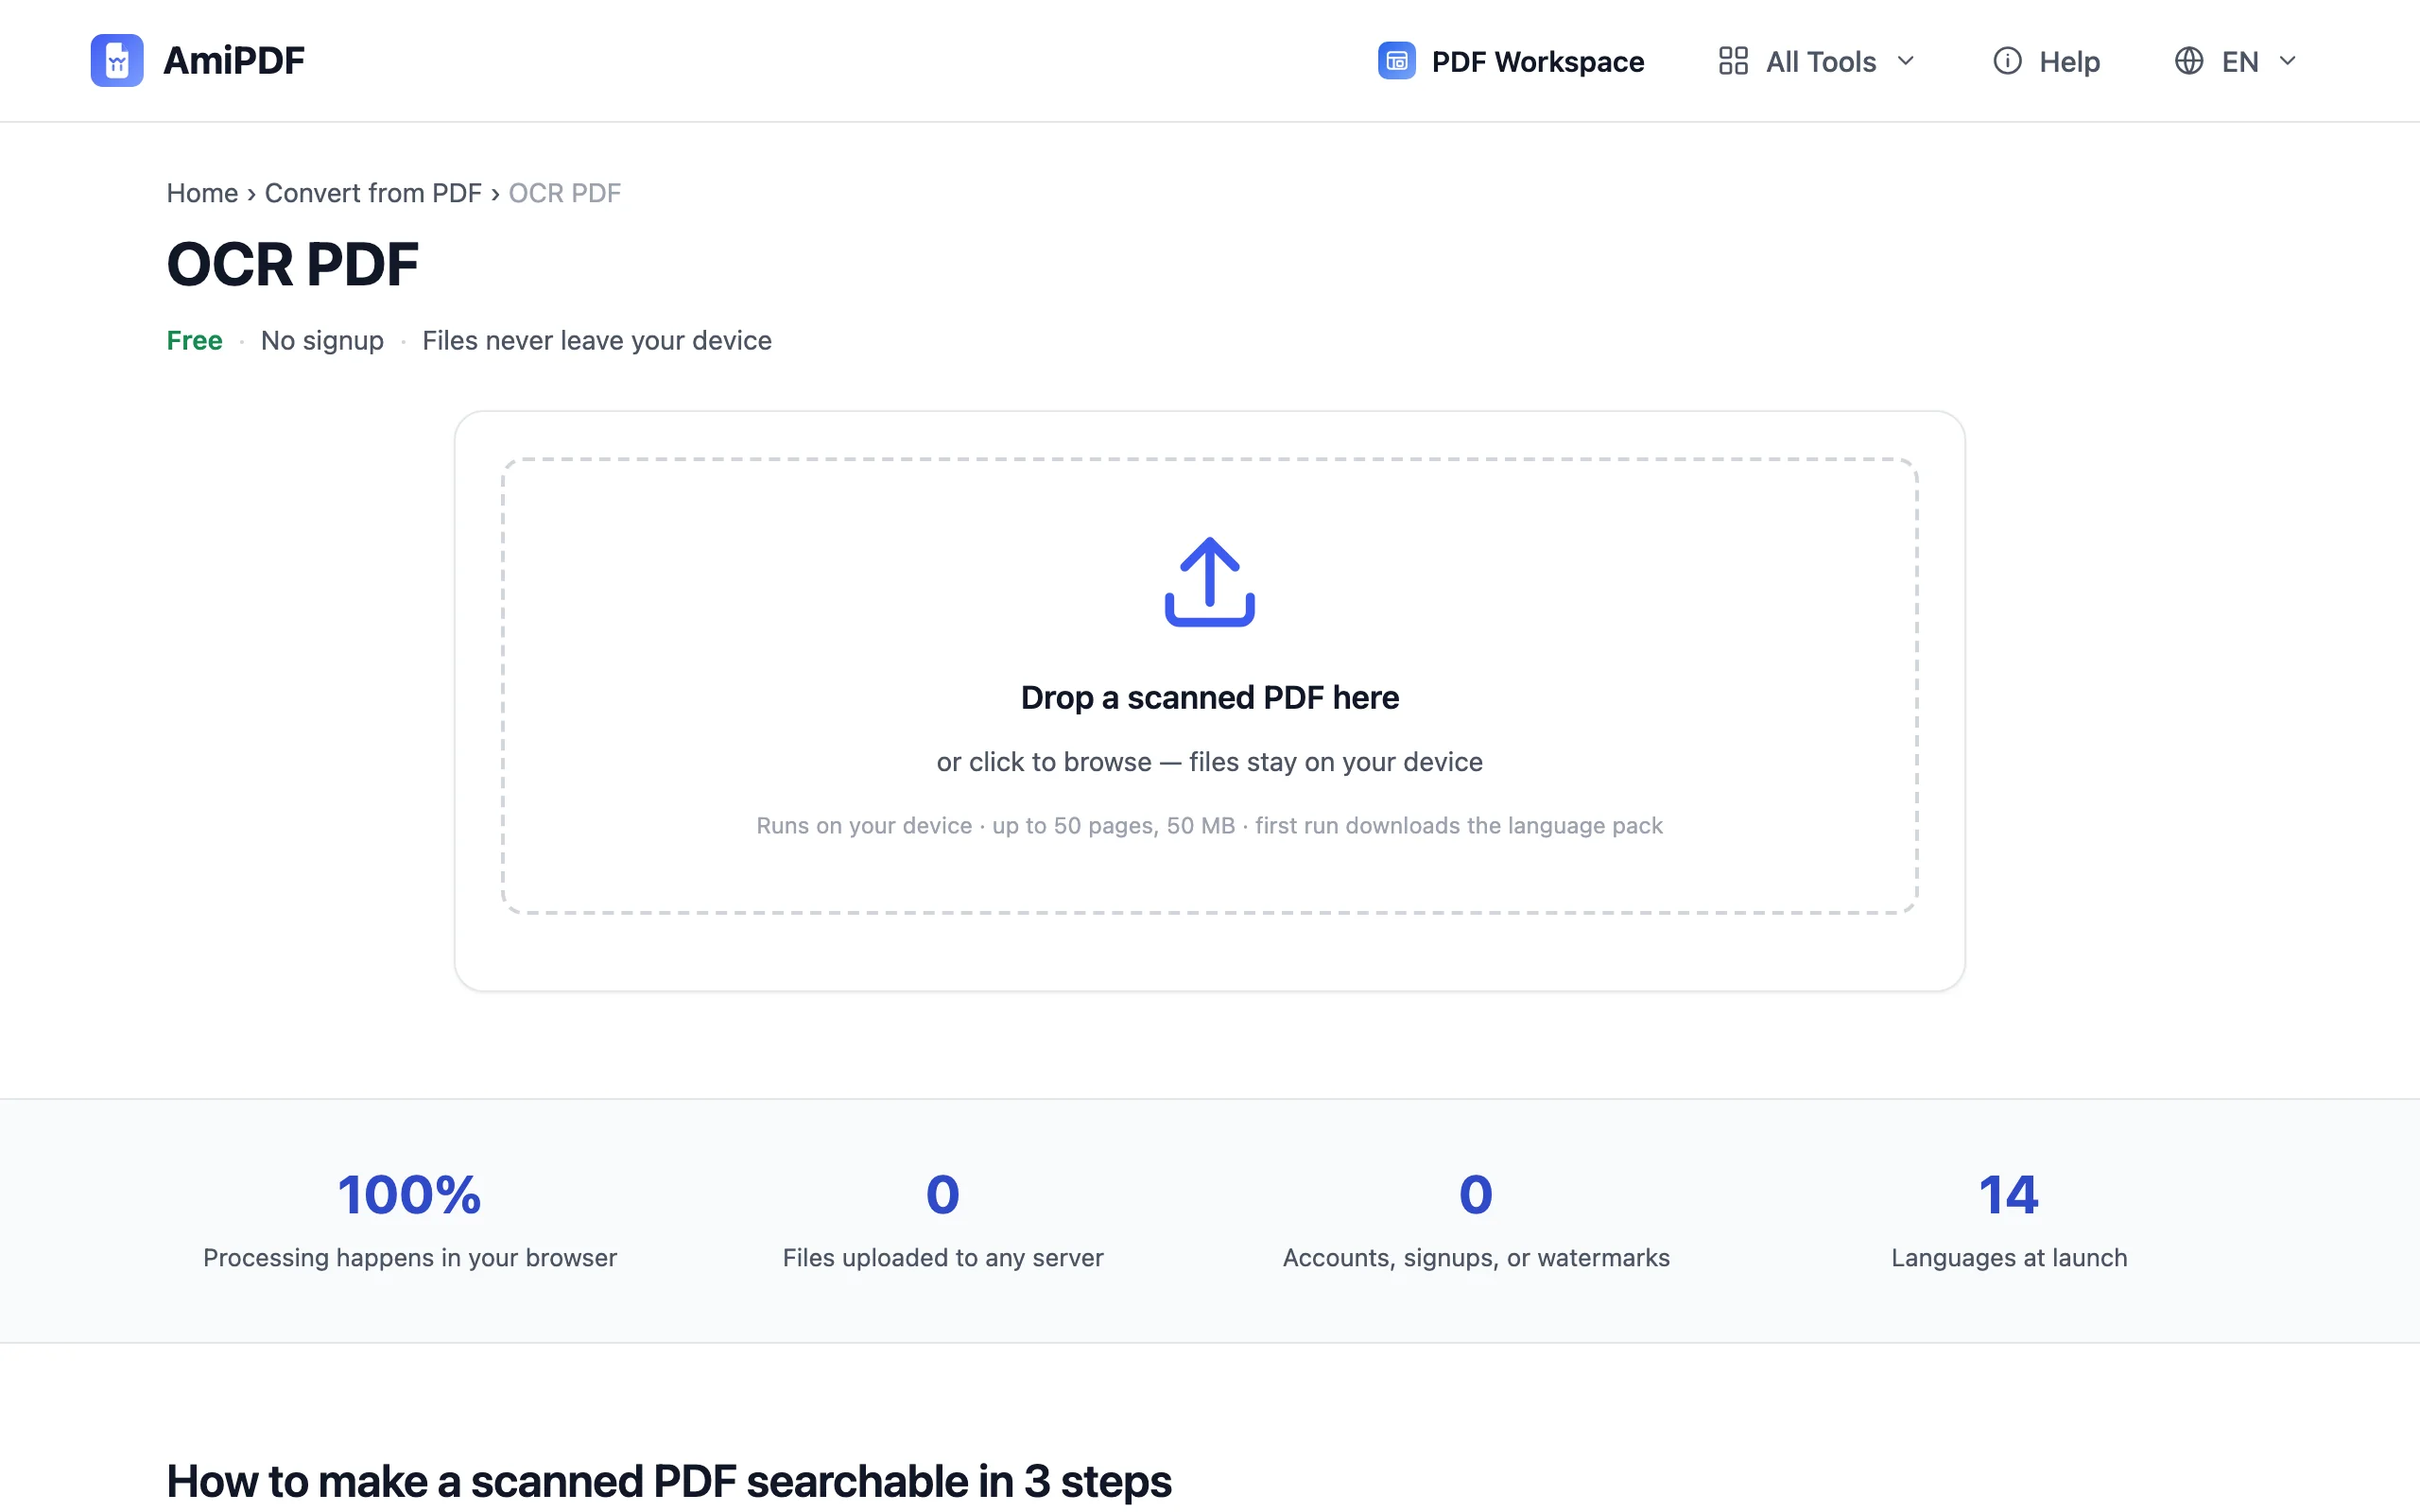
Откройте инструмент OCR и добавьте скан
Перейдите в инструмент OCR PDF AmiPDF и перетащите отсканированный PDF в область загрузки. Принимаются сканы в пределах ограничения по количеству страниц; если скан это длинная книга, сначала разрежьте её на части с помощью разделения PDF и обрабатывайте по частям.
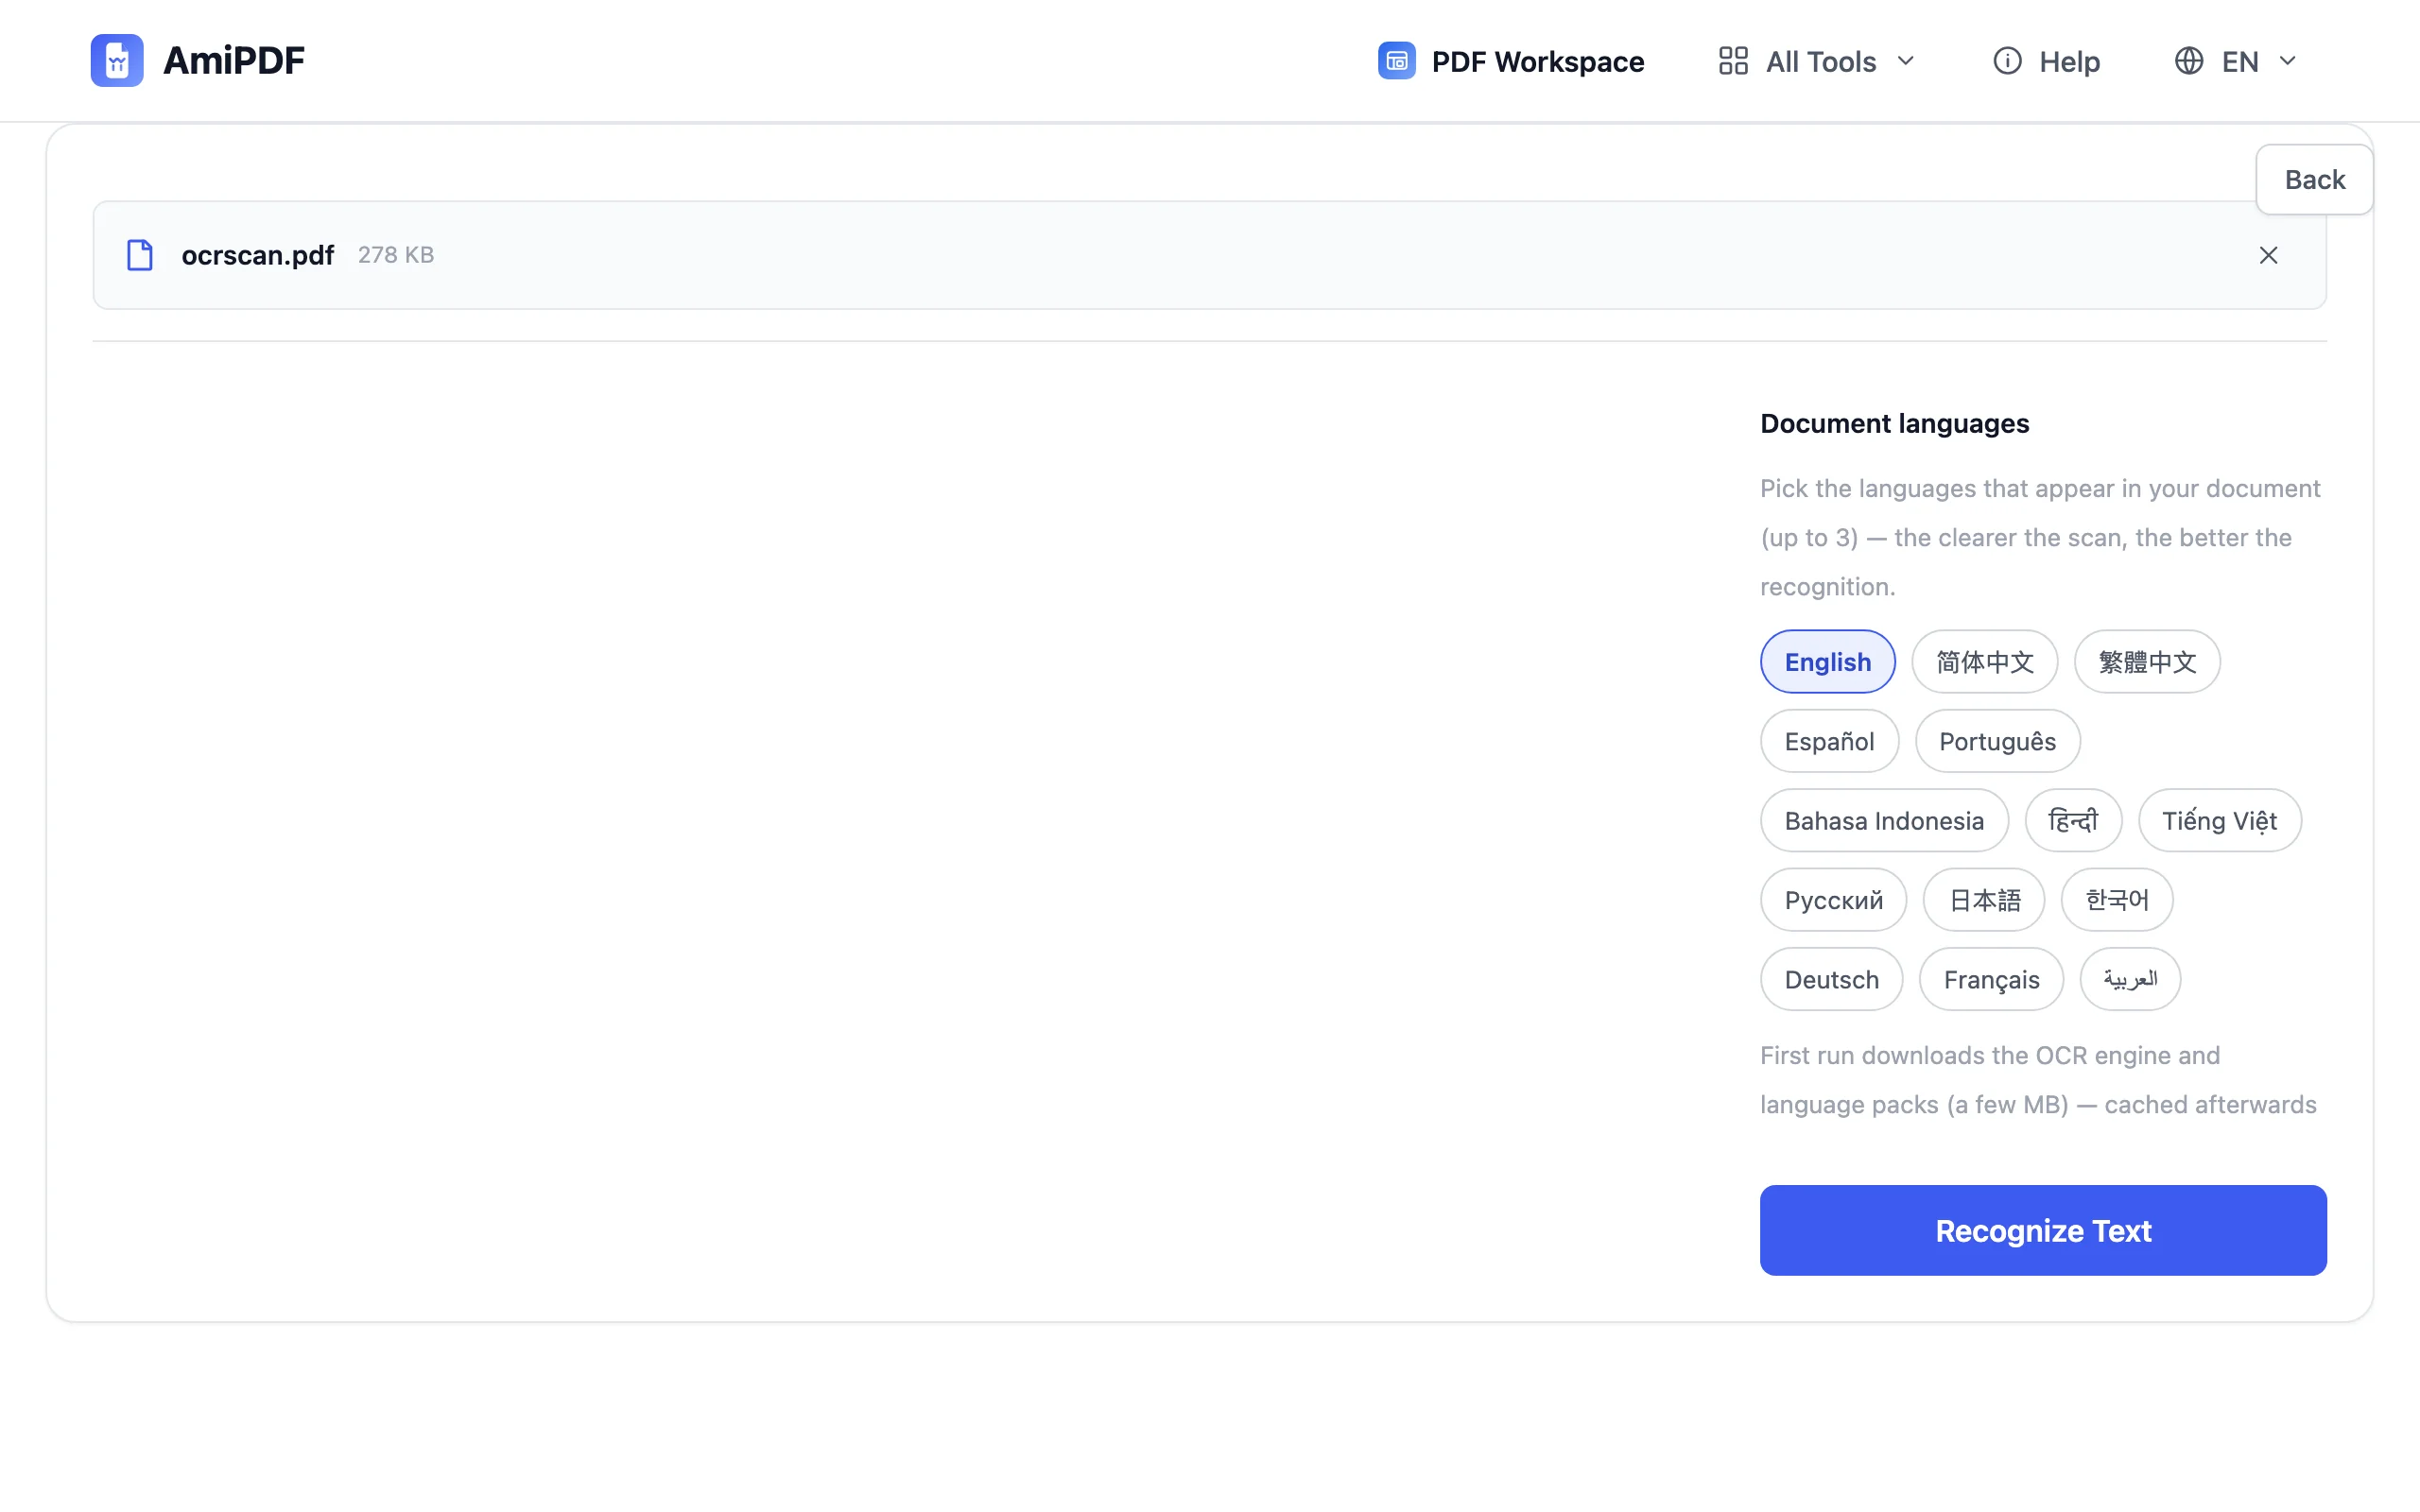
Выберите языки документа
Отметьте все языки, которые встречаются в документе, в пределах ограничения на один запуск. Если текст действительно смешанный, выбор двух или трёх языков улучшает распознавание; добавление языков, которых в документе нет, только замедляет работу. Движок и языковые пакеты загружаются один раз при первом использовании, а затем берутся из кэша.
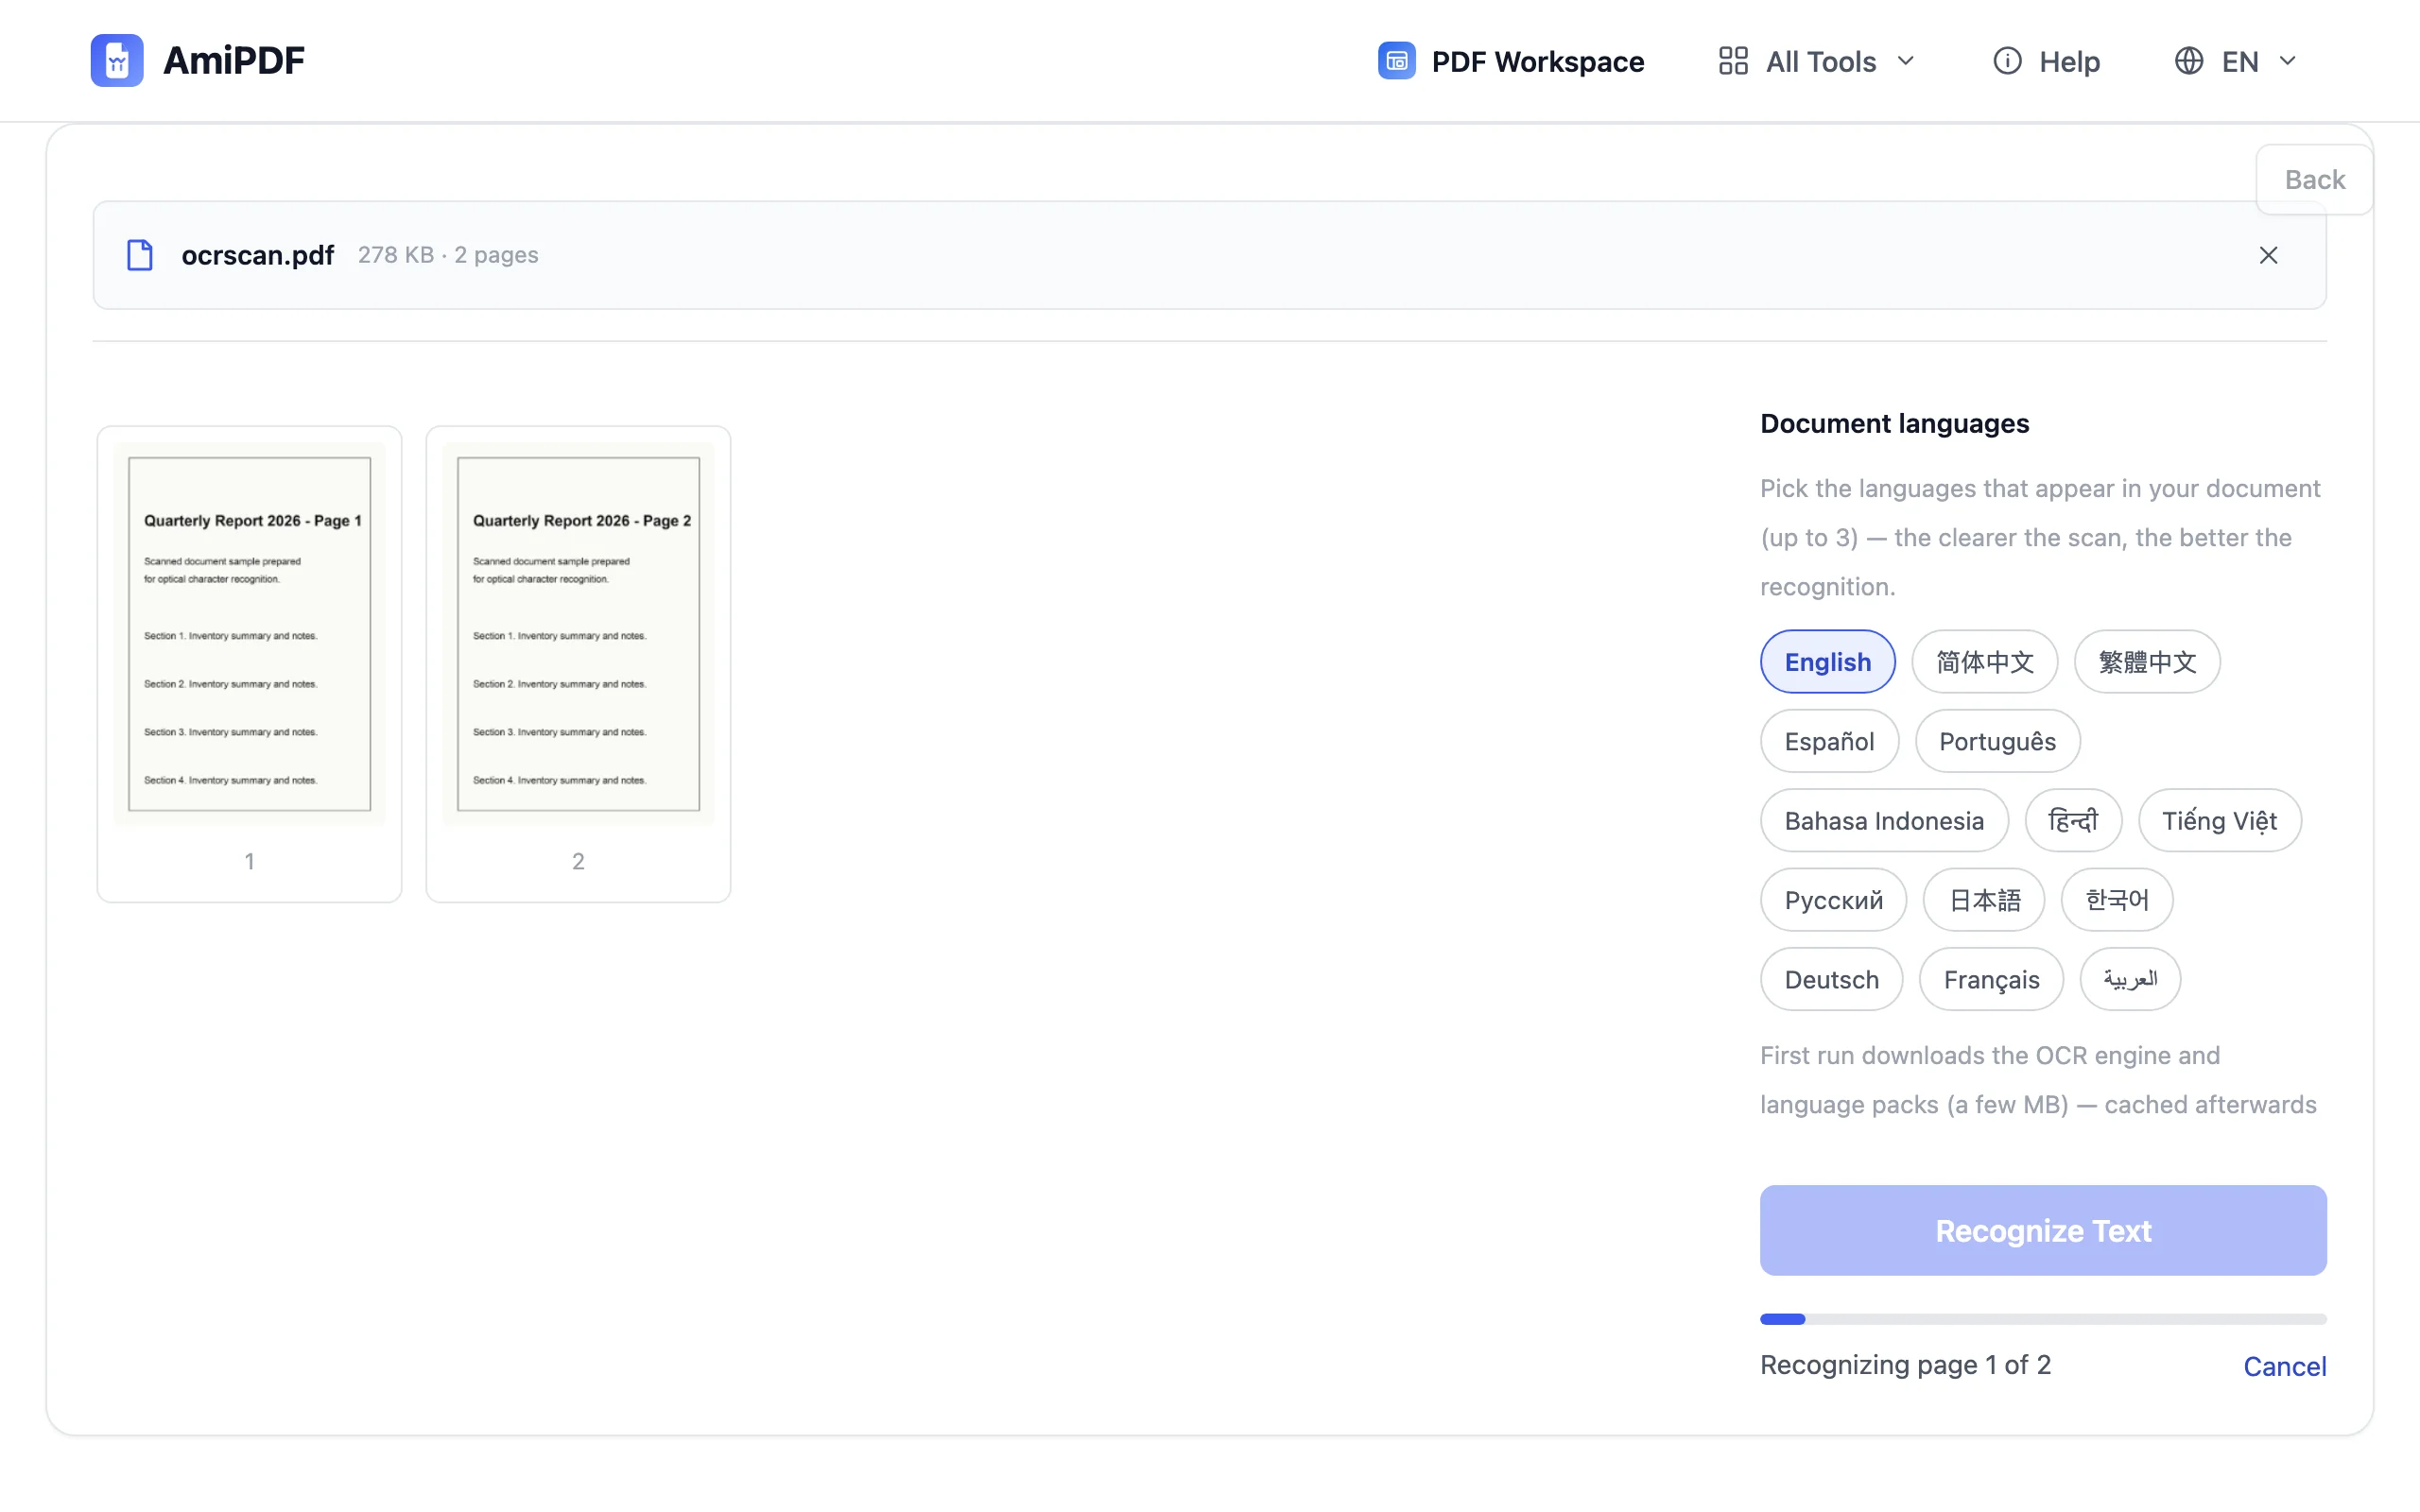
Запустите распознавание
Нажмите кнопку запуска и следите за прогрессом по страницам. Распознавание выполняется на вашем устройстве с помощью WebAssembly; скан из 10 страниц обычно обрабатывается за несколько минут, в зависимости от вашего компьютера. Не закрывайте вкладку до завершения работы: инструмент сам соберёт результат.
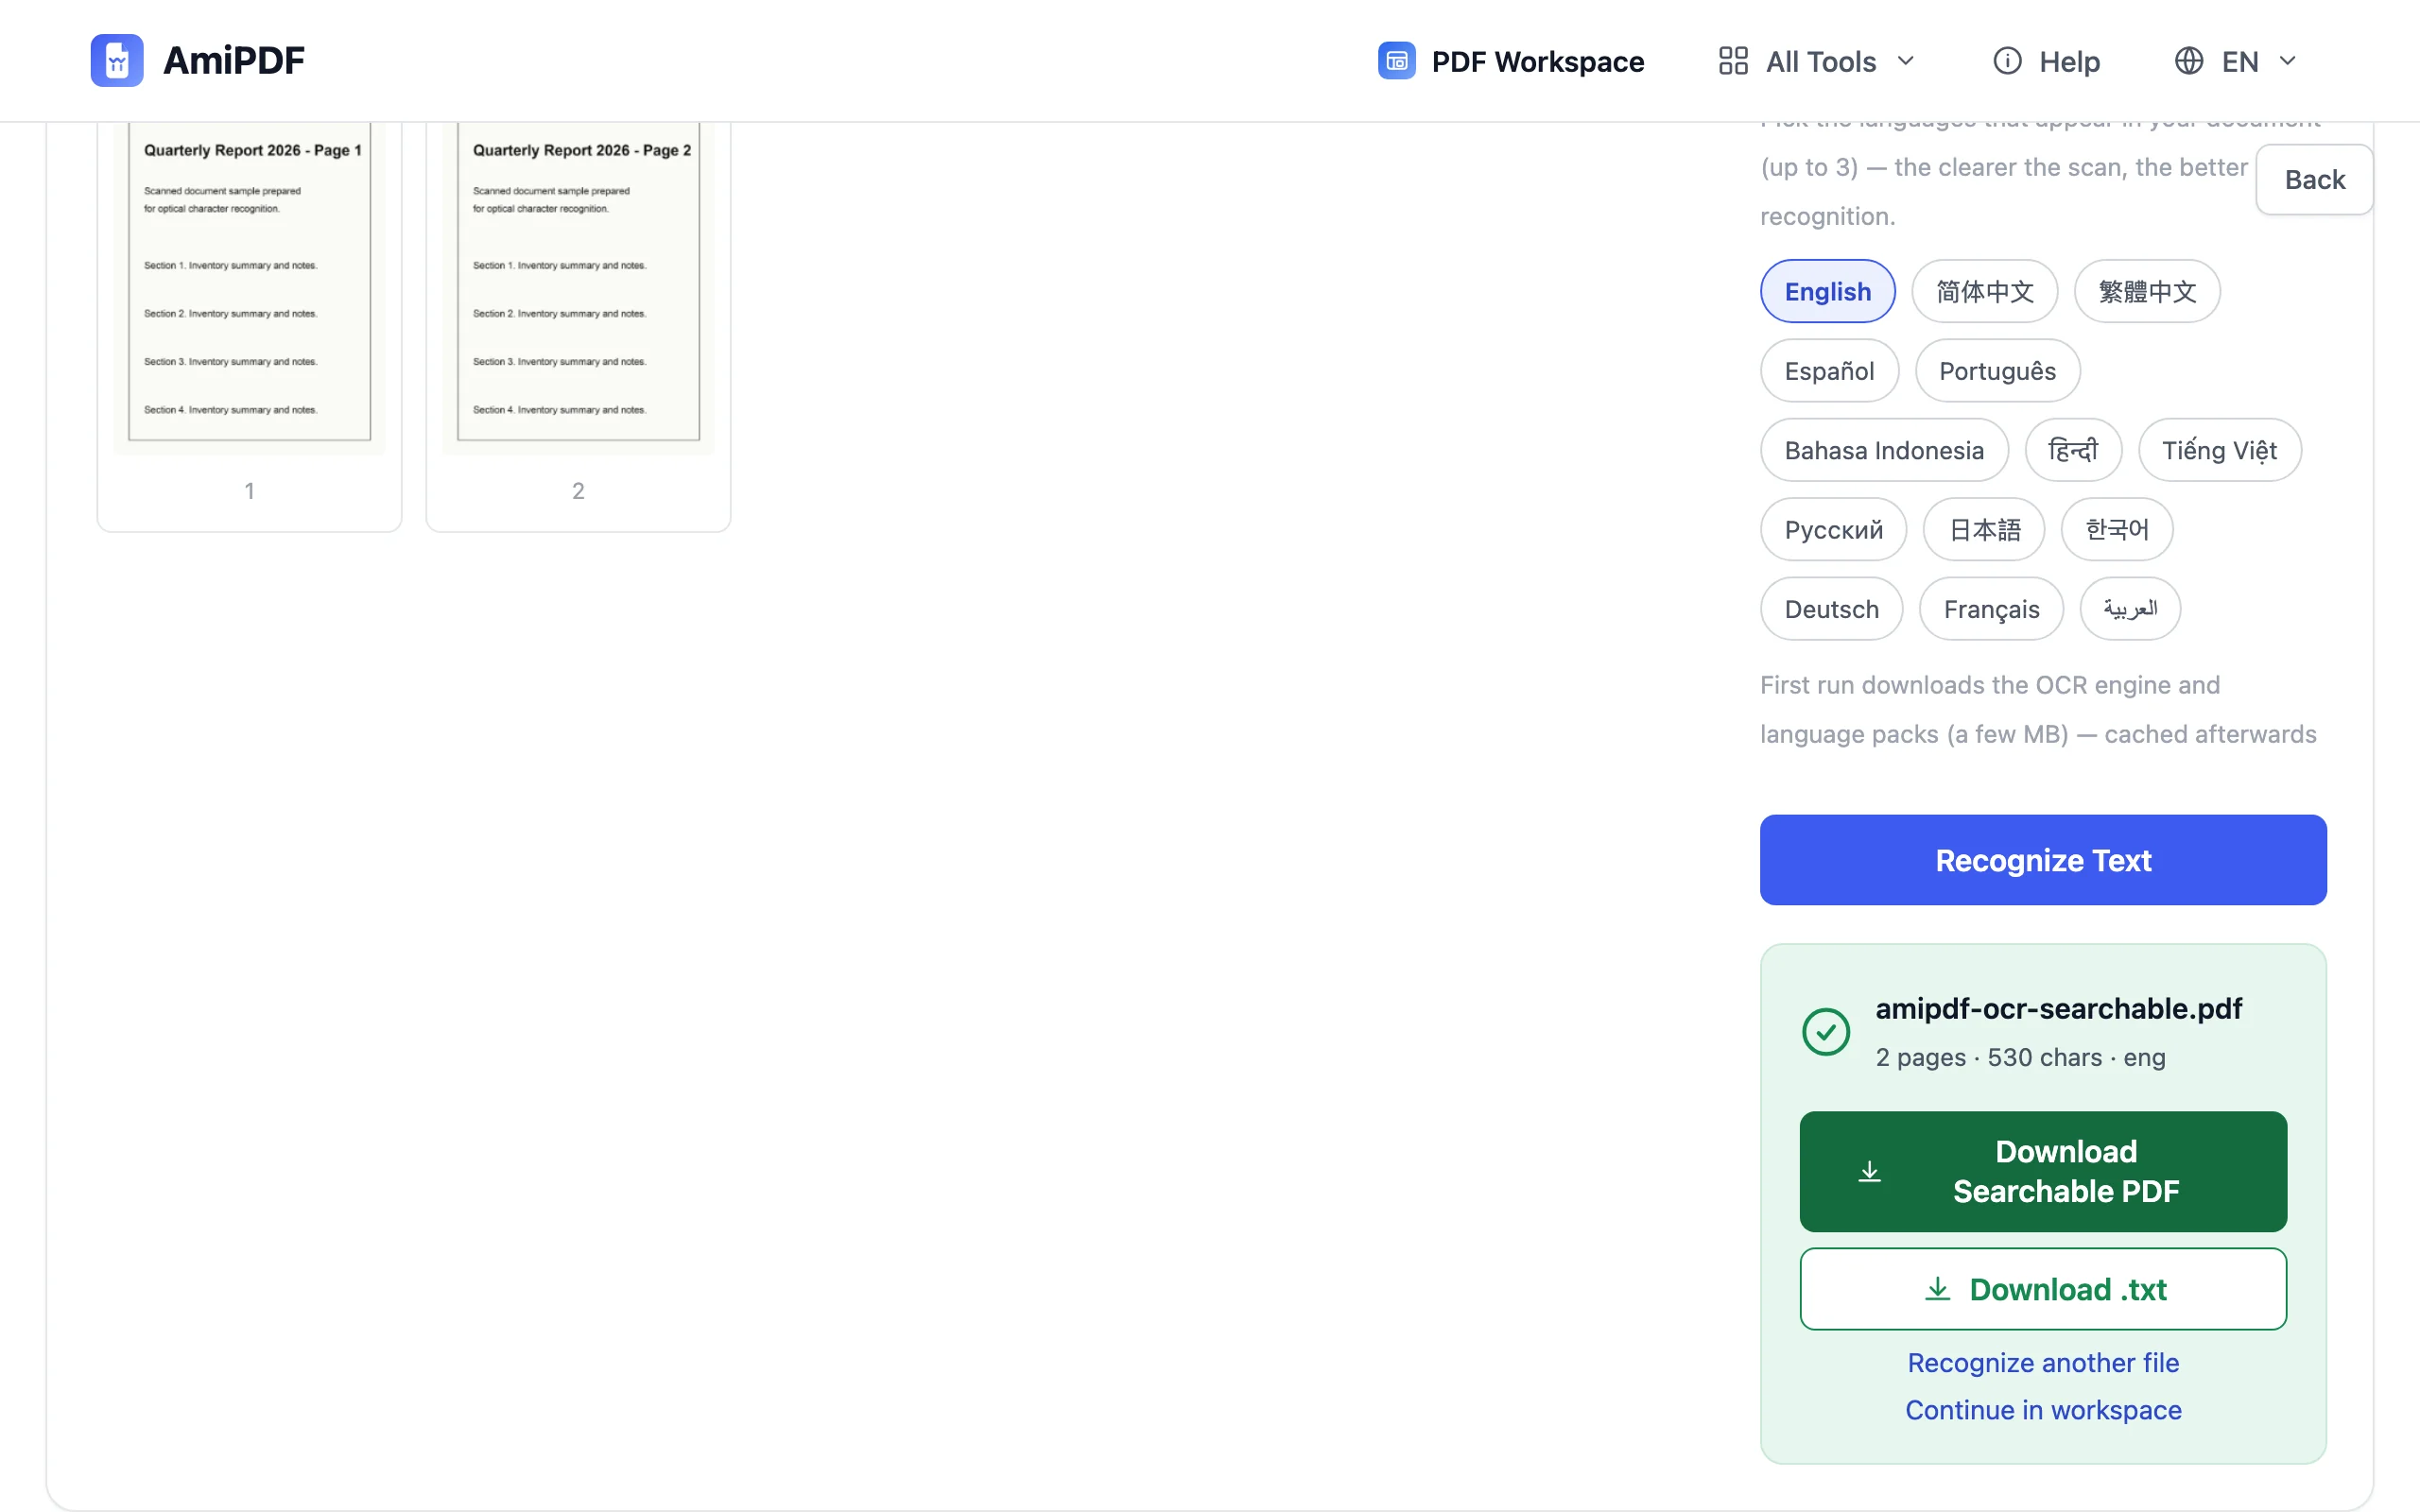
Скачайте PDF с текстовым слоем
Сохраните результат: это тот же документ визуально, но теперь под ним невидимый текстовый слой. Поиск работает в любой программе для PDF, копирование возвращает настоящий текст, а позже содержимое можно извлечь с помощью PDF в Markdown. Отдельная кнопка также предлагает распознанный текст в виде файла .txt для быстрой проверки.
Как получить лучший результат
Чистые сканы распознаются лучше
Ровные страницы с равномерным освещением и разрешением 300 DPI дают лучший результат. Наклонные фото со смартфона теряют точность по краям; если источник это камера телефона, сначала выровняйте и обрежьте снимок: инструмент обрезки PDF поможет убрать тёмные границы, которые мешают распознаванию.
Проверьте предпросмотр текста
OCR работает статистически: 100% точность не гарантируется, особенно при необычных шрифтах или низком контрасте. Просмотрите извлечённый текст и проверьте несколько абзацев, прежде чем полагаться на поиск, а если результат выглядит искажённым, запустите распознавание снова с другими языками.
Пропускайте OCR для текстовых PDF
Если инструмент сообщает, что в документе уже есть текстовый слой, OCR не нужен; инструменты извлечения, например PDF в Word, работают напрямую и завершают работу за секунды.
Частые вопросы
Мой файл действительно никуда не загружается?
Верно: распознавание выполняется в вашем браузере через WebAssembly. Сеть используется только для однократной загрузки движка OCR и языковых пакетов, которые затем кэшируются для следующих запусков.
Сколько языков можно выбрать?
Не больше ограничения на один запуск, указанного на странице. Смешивайте языки свободно, например английский и китайский в одном двуязычном договоре, но не добавляйте языки, которых нет в документе: они только замедляют работу.
Изменит ли OCR внешний вид скана?
Нет. Страницы сохраняют исходный вид; распознанный текст добавляется как невидимый слой под сканом. Документ выглядит так же, но поиск и копирование теперь работают.